На этой неделе авторы Хабра окончательно перешли от теоретических споров о моделях к инженерной обвязке и локальной инфраструктуре. В центре внимания — запуск тяжелых моделей масштаба 125B на скромных видеокартах без потери разрядности весов, разгон локальных агентов до 50 токенов в секунду через спекулятивный декодинг и построение трёхслойных контуров безопасности в Kubernetes. Разработчики больше не полагаются на системные промпты: в ход пошли файловые деревья инструментов, локальная память с забыванием устаревших уроков и жесткие сетевые фильтры.
⚡
Главные статьи недели
01
Запуск Qwen3.8-Flash-Next 125B на 6 ГБ VRAM через послойный стриминг
Практический запуск открытого чекпойнта Qwen3.8-Flash-Next на 125 миллиардов параметров в полном bfloat16 на потребительской видеокарте. Инженеру это позволяет запускать frontier-модель локально для кодинга и агентных задач без 4-битной деградации весов.
🔑 Главное
Пиковый расход видеопамяти удержан на отметке 5,95 ГБ благодаря библиотеке AirLLM версии 3.3.0 и выше.
Архитектура модели состоит из 48 гибридных слоёв MoE (~6B активных параметров на токен) и отдельной таблицы n-gram эмбеддингов на 51B весов (102 ГБ).
Таблица n-gram не загружается целиком в видеопамять, а проецируется в оперативную память хоста через механизм memory mapping (mmap).
Блок компьютерного зрения (vision tower) остаётся резидентным в GPU, а декодер последовательно подгружает слои с NVMe-накопителя.
⚡ Попробовать за вечер
Обновить пакет инференса командой pip install -U "airllm>=3.3.0" и загрузить веса модели Qwen/Qwen3.8-Flash-Next.
Запустить скрипт генерации через стандартный интерфейс AutoModel.from_pretrained() с текстовым запросом.
Метрика: утилизация памяти GPU в nvidia-smi не превышает 6,0 ГБ во время послойного вывода.
из статьи
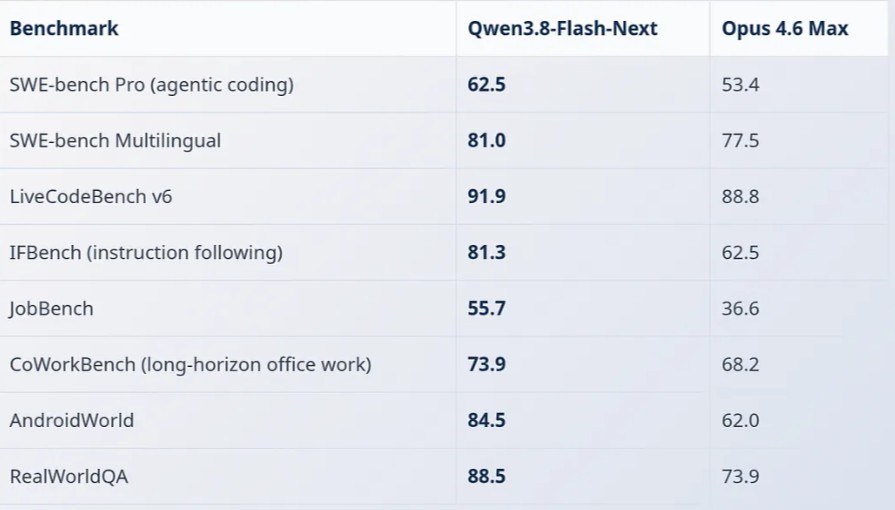
На картинке: сравнительная таблица бенчмарков Qwen3.8-Flash-Next против Opus 4.6 Max (62.5 против 53.4 на SWE-bench Pro).
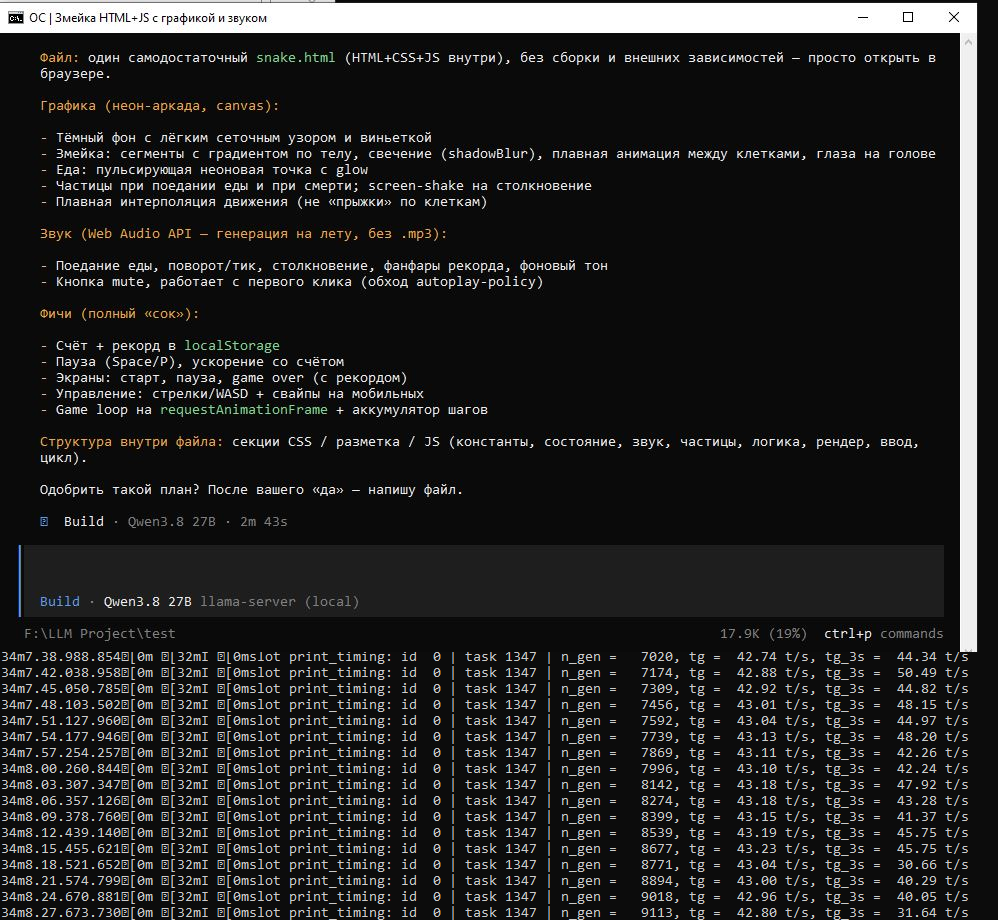
Конфигурация быстрого локального агента разработки на базе видеокарты RTX 5060 Ti с квантованной моделью Q3_K_XL и контекстом 92k токенов. Инженеру даёт полностью автономную среду для написания кода без задержек облачных провайдеров.
🔑 Главное
Квант Qwen3.8-27B-Unleashed-UD-Q3_K_XL размером 13,2 ГБ оставляет запас видеопамяти под объёмный контекст и буфер рассуждений.
Спекулятивный декодинг MTP (Multi-Token Prediction) повышает скорость генерации кода до 40–50 токенов в секунду.
Квантование кэша ключей и значений флагами -ctk q4_0 -ctv q4_0 позволяет удерживать 92 160 токенов контекста прямо в VRAM.
Интеграция с OpenCode через драйвер @ai-sdk/openai-compatible и плагин superpowers даёт пошаговое планирование задач по TDD.
Локальная диктовка на macOS без GPU: утилита «Писарь» на базе GigaAM
✍ ladaprioraХабр⏱ ≈3 минOpen sourcemacOSРаспознавание речи
О чём
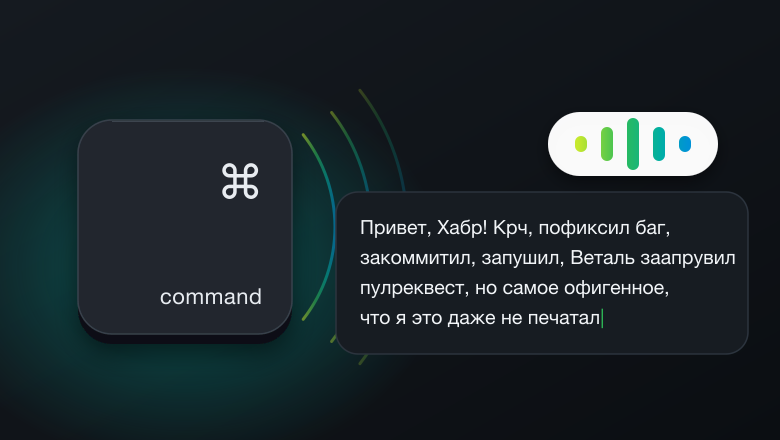
Открытая легковесная утилита голосового ввода для macOS, работающая на процессоре без нагрева видеокарты и внешних серверов. Инженеру помогает надиктовывать длинные промпты, документацию и комментарии к коду в несколько раз быстрее ручного набора.
🔑 Главное
Открытая модель GigaAM от Сбера занимает 204 МБ и оптимизирована под русскую речь с техническими англицизмами.
Скорость распознавания: аудио длительностью 6 секунд транскрибируется и вставляется в поле ввода за 0,08 секунды.
Холодный старт модели занимает 0,22 секунды, а расшифровка 30 секунд речи укладывается в 0,5 секунды.
Доступны голосовые команды постобработки («причеши», «переведи», «сократи») через локальную модель весом 2,5 ГБ.
⚡ Попробовать за вечер
Установить бинарник с открытого сайта gigapisar.github.io и предоставить права на микрофон.
Зажать правый ⌘ Command, произнести сложную техническую фразу и отпустить клавишу.
Метрика: готовый текст с расставленными знаками препинания появляется в строке курсора быстрее чем за 0,2 секунды.
из статьи
На картинке: рабочий процесс диктовки через удержание правой клавиши Command с виджетом распознавания.
Архитектура делегирования рутины вокруг репозитория (Jira, GitLab, Jenkins, Sentry) AI-агенту через строгие текстовые регламенты. Освобождает разработчикам до 2–3 часов в день от переключения между трекерами и сборщиками.
🔑 Главное
Разделение инструкций на три независимых слоя: сценарии процессов (playbooks), атомарные действия (actions) и протокол вызовов API (MCP).
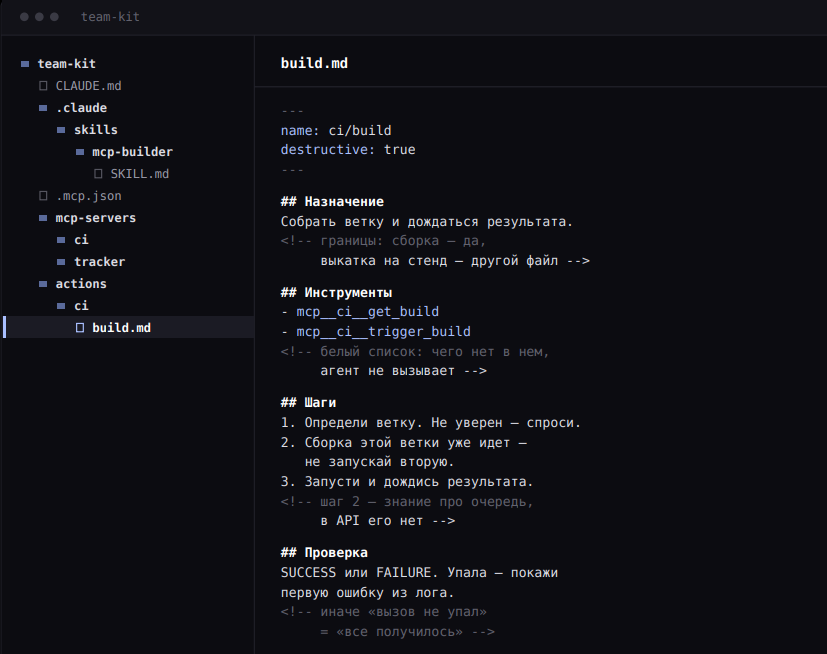
Каждый action представляет собой компактный markdown-файл на 50–70 строк со строгим белым списком разрешённых инструментов.
Явная верификация результата: агент не считает задачу закрытой по коду 200, а проверяет возврат ID комментария или статус сборки.
Разграничение прав в .claude/settings.json отделяет фоновое чтение от опасных действий, требующих подтверждения человека.
⚡ Попробовать за вечер
Описать регулярное действие команды в файле actions/ci/build.md с разделами «Назначение», «Инструменты», «Шаги» и «Проверка».
Связать действие с нижнеуровневым MCP-сервером трекера и зафиксировать сценарий вызова в корневом файле CLAUDE.md.
Метрика: агент собирает проект и переводит задачу в трекере без вызова несанкционированных функций.
из статьи
На картинке: структура файла действия build.md с белым списком инструментов и блоком верификации.
Инженерный разбор внутреннего устройства агентных фреймворков (OpenClaw и Hermes), ReAct-циклов и подходов к памяти. Помогает разработчику понять механику диспетчеризации функций и собрать предсказуемого помощника без тяжелых библиотек.
🔑 Главное
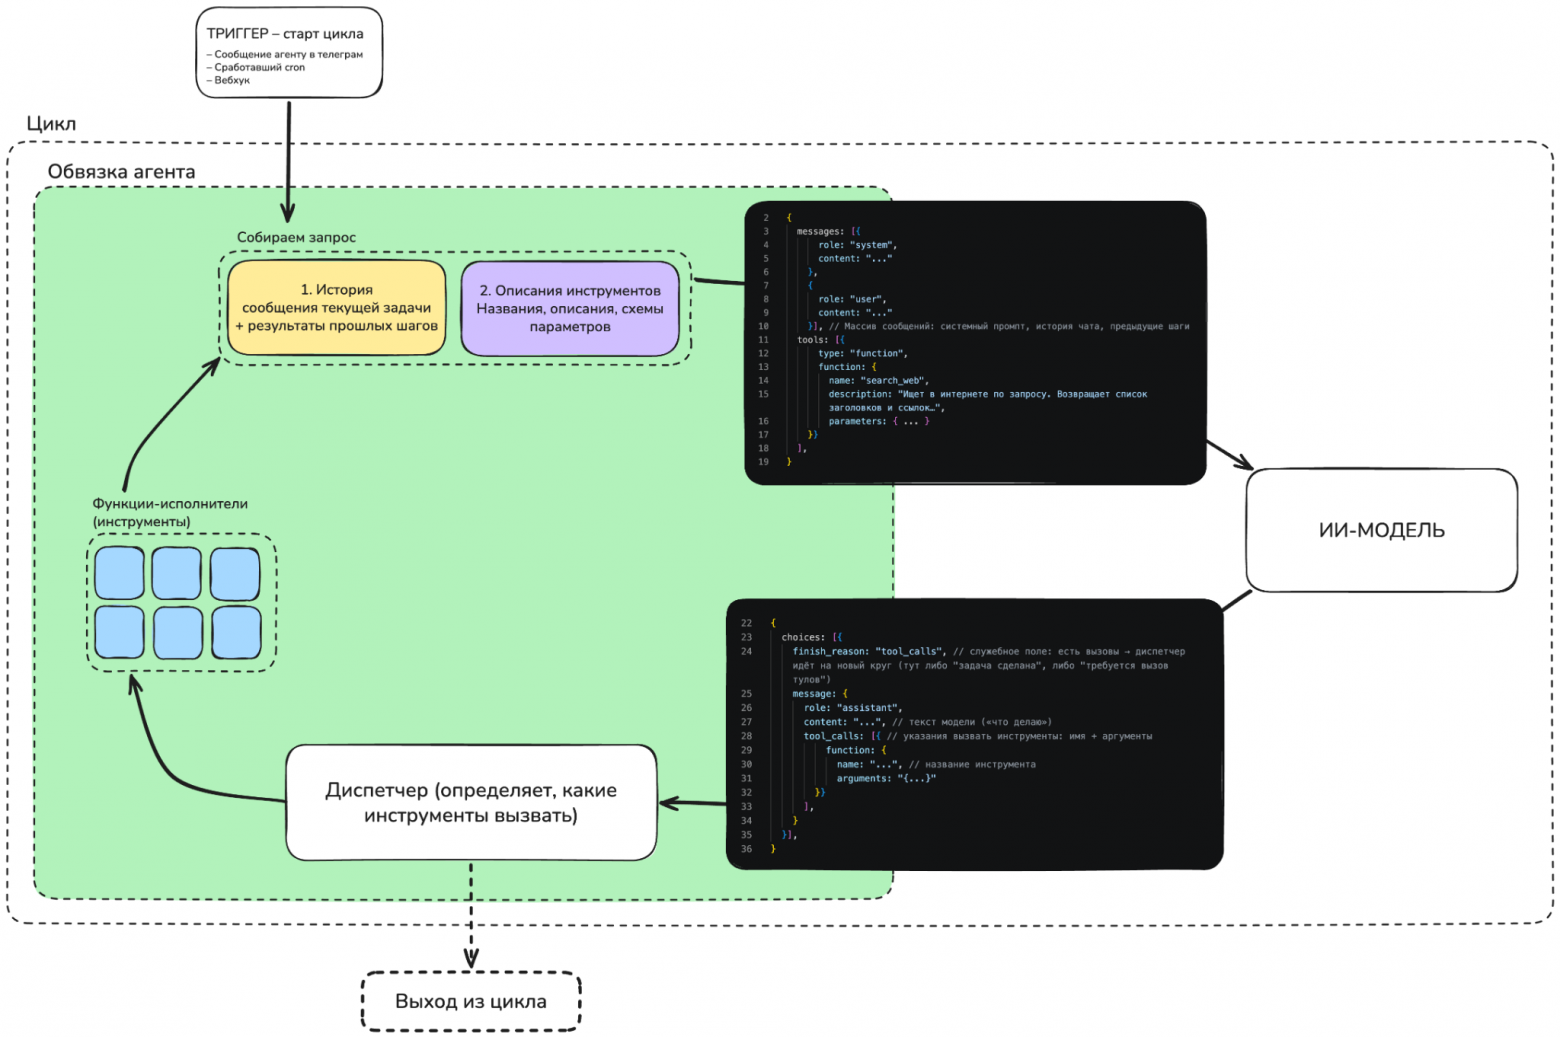
Любой агент держится на базовом цикле: внешний триггер -> сбор контекста со схемами функций -> ответ модели -> вызов тулов -> условие выхода.
Модель возвращает только текстовые инструкции в JSON; выполнение команд и изоляция среды лежат целиком на локальном коде.
Архитектура памяти Hermes состоит из трёх слоёв: проектные файлы контекста, векторный архив диалогов и библиотека отработанных навыков.
Описания инструментов работают как программные ограничения: текстовый запрет вызова sleep предотвращает блокировку агентского цикла.
⚡ Попробовать за вечер
Написать диспетчер вызовов на Node.js, принимающий JSON с описанием функций и исполняющий их на локальной машине.
Подключить триггер по расписанию cron для периодического сбора данных и отправки результатов в Telegram-бота.
Метрика: агент выполняет цепочку из трёх последовательных шагов с вызовом инструментов и корректно выходит из цикла.
из статьи
На картинке: ReAct-цикл агента с диспетчеризацией вызовов инструментов и возвратом данных в контекст.
Опыт команды МТС CVM по созданию ассистента менеджеров по базе из 100+ B2B-продуктов со сложной иерархией страниц. Инженеру показывает, как исключить ложные факты при поиске по разветвленной корпоративной документации.
🔑 Главное
Парсинг 77 подстраниц на продукт через Crawl4AI и Playwright сразу в Markdown с очисткой от HTML-мусора через Markdownify.
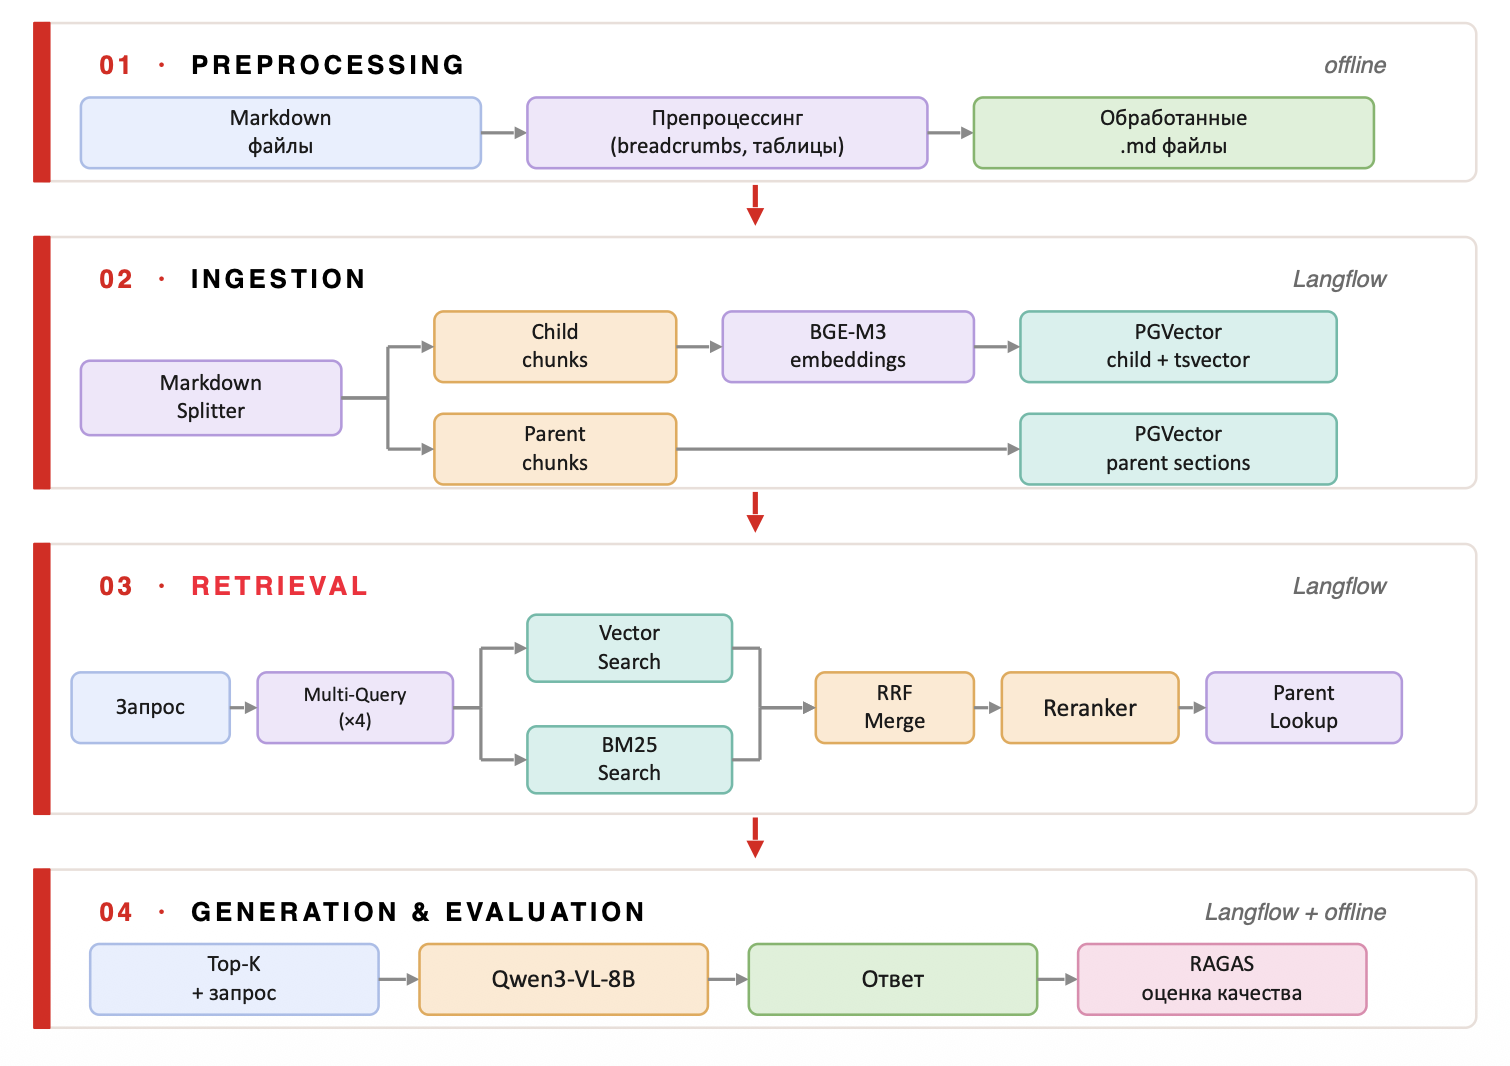
Конвейер из четырех стадий: предобработка разметки, индексация child/parent чанков в PGVector, гибридный поиск и оценка в RAGAS.
Слияние результатов плотного векторного поиска (BGE-M3) и полнотекстового BM25 через алгоритм Reciprocal Rank Fusion (RRF).
Каждый факт ответа снабжается ссылкой на цепочку разделов (хлебные крошки), а при нехватке данных модель возвращает отказ.
⚡ Попробовать за вечер
Собрать конвейер выгрузки документации через Crawl4AI с автоматическим извлечением пути к странице.
Настроить гибридное ранжирование результатов BM25 + PGVector по формуле RRF с константой k=60.
Метрика: все ответы ассистента содержат точный путь к исходному документу либо статус «не найдено».
из статьи
На картинке: архитектурная карта пайплайна: препроцессинг, инджест, гибридный поиск и оценка качества в RAGAS.
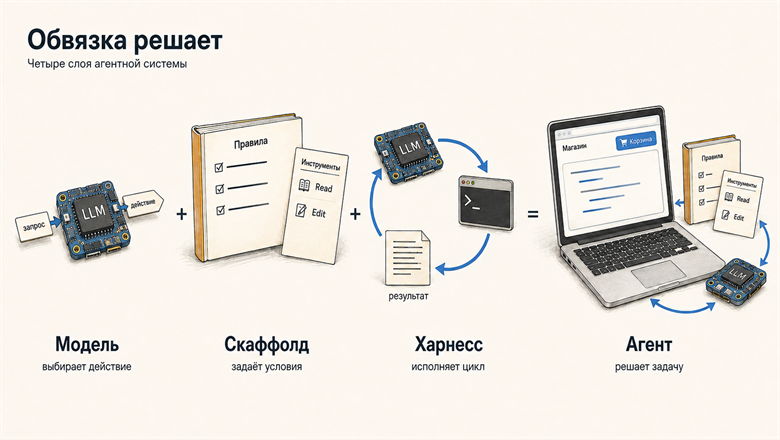
Глубокий разбор компонентов агентных систем по формуле Model + Scaffold + Harness = Agent с замерами на бенчмарках SWE-bench и Terminal-Bench. Показывает, как правильная настройка хуков и правил поднимает точность агента без замены языковой модели.
🔑 Главное
На фиксированной модели Claude Opus 4.5 переход с базового SWE-agent на обвязку Claude Code повышает результат с 45,9% до 55,4% (+9,5 п.п.).
Разработчики LangGraph подняли показатель с 52,8% до 66,5% на Terminal-Bench 2.0 без изменения модели, лишь добавив middleware проверок.
Сокращение набора инструментов с 17 до 2 в агенте Vercel повысило долю успешно решенных задач с 80% до 100%.
Жизненный цикл харнесса опирается на хуки: pre-tool фильтрует аргументы, post-tool проверяет вывод, а stop-gate запрещает коммит без тестов.
⚡ Попробовать за вечер
Закрепить в файле правил AGENTS.md обязательный прогон тестов перед фиксацией изменений в git.
Добавить в конфигурацию агента перехватчик, блокирующий завершение задачи при наличии неразрешённых ошибок линтера.
Метрика: агент не создаёт pull request с непроверенными или падающими тестами.
из статьи
На картинке: разделение агентной системы на модель, скаффолд, исполнительный харнесс и итогового агента.
Инфраструктурная изоляция автономных агентов в Kubernetes при исполнении недоверенных промптов. Даёт инженеру манифесты для защиты от несанкционированного доступа к данным, взлома контейнеров и сетевой эксфильтрации.
🔑 Главное
Промпт-фильтры не защищают от инъекций: изоляция агента должна обеспечиваться на уровне ядра ОС и сети кластера.
Слой runtime: запуск агента через спецификацию Sandbox CRD с параметром runtimeClassName: gvisor перехватывает системные вызовы userspace-ядром.
Слой деплоя: изолированный ServiceAccount без автоматического монтирования токенов и ResourceQuota с лимитом на количество подагентов.
Слой сети: применение NetworkPolicy по правилу default-deny с разрешением выхода наружу только через egress-прокси по белому списку хостов.
⚡ Попробовать за вечер
Развернуть тестовый под агента с параметром runtimeClassName: gvisor в выделенном пространстве имён.
Применить манифест NetworkPolicy, отсекающий весь исходящий сетевой трафик, кроме внутреннего прокси.
Метрика: прямой вызов curl к неавторизованному внешнему ресурсу внутри пода завершается сбоем соединения на уровне сети.
из статьи
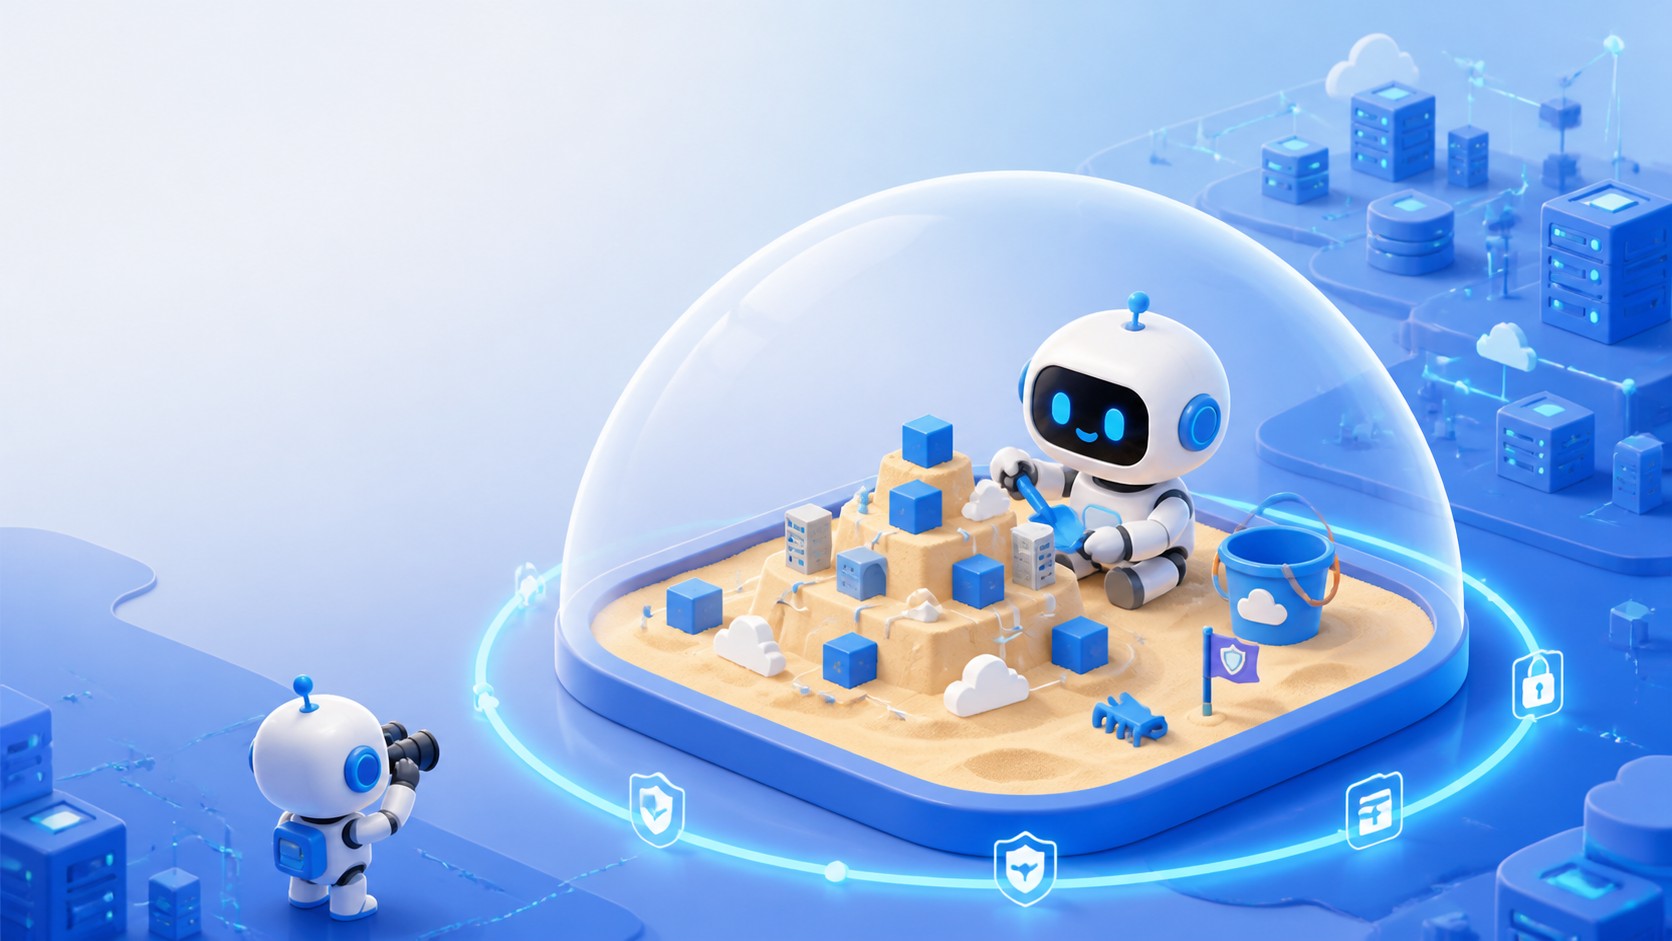
На картинке: три уровня защиты: изоляция ядра в gVisor, лимиты ресурсов подов и сетевой egress-фильтр.
Открытый локальный инструмент долговременной памяти для агентов, который сохраняет отработанные процедуры и уроки прошлых задач без затрат на токены модели. Инженеру помогает избавиться от повторения агентом одних и тех же граблей между сессиями.
🔑 Главное
Запись навыка (триггер, шаги, результат, выводы) выполняется прямым INSERT в локальную SQLite без обращения к LLM.
Офлайн-поиск объединяет полнотекстовый индекс FTS5 с раздельным стеммингом для русского и английского языков и ONNX-эмбеддинги на CPU.
Механизм забывания по кривой Эббингауза: сила навыка затухает на 15% за период простоя, отправляя неиспользуемые правила в архив через 90 дней.
Криптографическая цепочка SHA-256 hash-chain защищает историю навыков от несанкционированной подделки через внедрённые промпты.
⚡ Попробовать за вечер
Установить библиотеку командой pip install skillmem и выполнить skillmem init --claude-code.
Зафиксировать полезный урок через команду skillmem learn с описанием контекста проблемы и решения.
Метрика: команда skillmem verify --strict подтверждает валидность цепочки хэшей, а mem_recall извлекает навык в новой сессии.
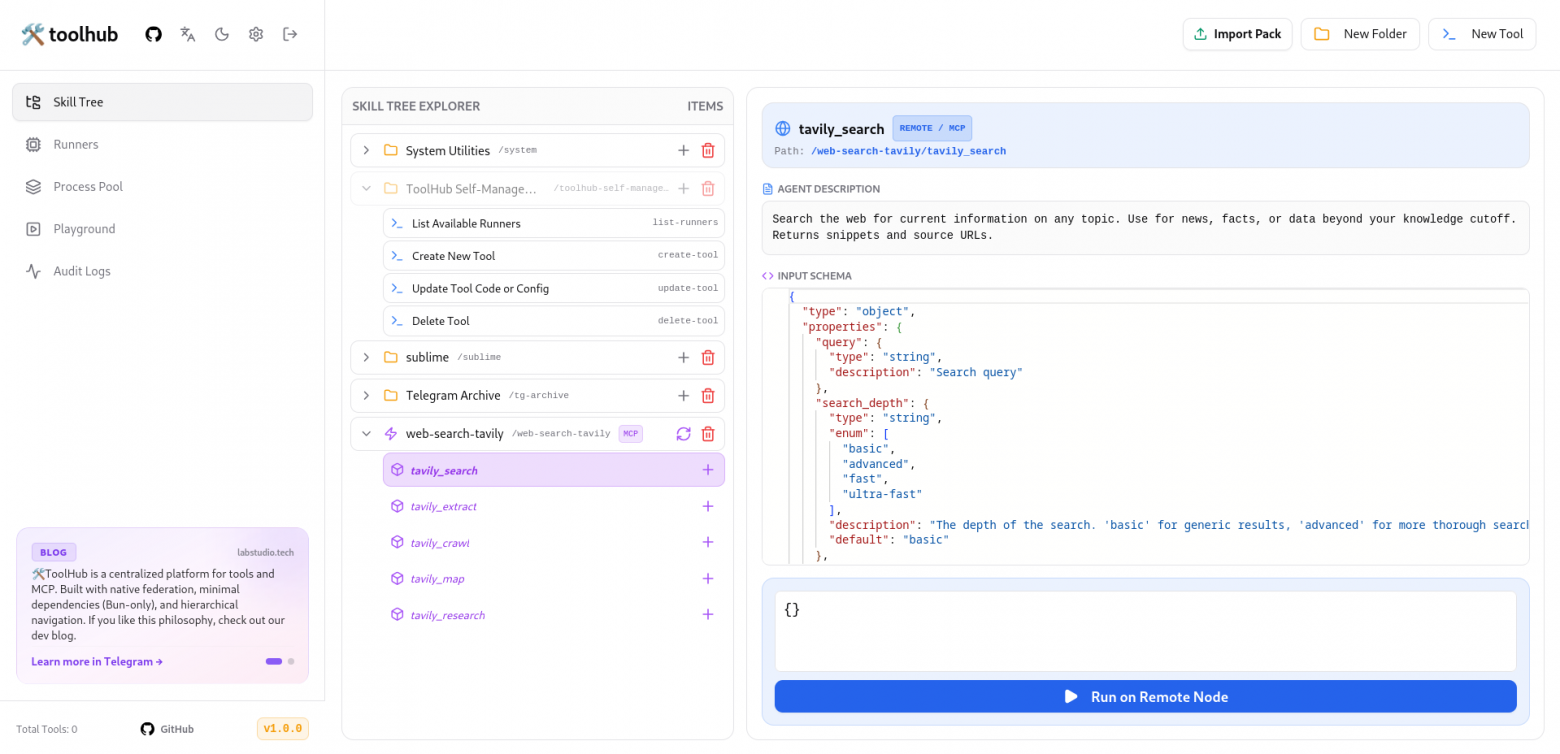
Легковесный self-hosted сервер на Bun и Fastify, превращающий локальные скрипты (Bash, Python, Go) в инструменты для агентов без написания сетевого бойлерплейта MCP. Инженеру помогает сохранить окно контекста чистым за счёт древовидной навигации.
🔑 Главное
Иерархическое дерево навыков вместо плоского списка 100 функций: модель запрашивает схемы только нужной категории при необходимости.
Вызов инструментов через компактные команды listTools и callTool предотвращает потерю контекста (Lost in the Middle).
Изолированный запуск процессов во временных каталогах с автоматической передачей аргументов в переменные окружения.
Пул постоянных процессов (Stateful Pool) для тяжелых подключений (SSH, СУБД) обеспечивает время отклика в пределах 10–30 мс.
⚡ Попробовать за вечер
Клонировать репозиторий github.com/Talos-popcorn/toolhub и запустить сервер через bun start.
Добавить собственный скрипт автоматизации в каталог /system/ и протестировать запуск через панель управления.
Метрика: повторное выполнение функции из пула процессов отрабатывает менее чем за 30 миллисекунд.
из статьи
На картинке: панель управления ToolHub с иерархическим деревом инструментов и редактором схем вызова.
Движок cortiq 0.6.6 предлагает режим O(1) для full-attention слоёв, заменяя растущую память состоянием в 44,1 МиБ на любой длине контекста. Экономит до 4 ГБ VRAM на 64k токенов ценой приблизительного восстановления дальних фактов.
Замеры на задачах управления GoCD показали, что на простых вызовах нативный API с curl обходится дешевле MCP за счёт чистого контекста. Однако на цепочках с optimistic locking и валидацией ETag сервер окупает разработку.
Практический разбор инъекции в сервисе проверки договоров: модель вернула инструкции внутри JSON-шаблона. Автор показал, почему фильтрация текста отсекает только примитивные атаки, а подозрительные фразы в документах требуют вывода предупреждения пользователю.
Опыт создания «второй памяти» из десятков тысяч сообщений через DeepSeek с извлечением структурированных сущностей (люди, проекты, факты) и прямой связью с исходными репликами вместо нарезки диалогов на слепые чанки.
Два конкретных инженерных шага по материалам выпуска, которые стоит протестировать на рабочем оборудовании.
Развернуть локальный кодинг-агент: запустить Qwen3.8-27B в llama-server со спекулятивным декодингом MTP (--spec-type draft-mtp --spec-draft-n-max 3) и подключить к OpenCode с плагином superpowers для TDD.
до среды
Подключить процедурную память skillmem в Claude Code: настроить локальное SQLite-хранилище навыков (skillmem init --claude-code) и сохранить первые уроки решения багов миграций.
до пятницы
#
Метаданные
сгенерировано 2026-09-14T07:25:00+03:00
окно 2026-09-07 — 2026-09-14 (7 дней)
отсканировано / в дайджест 296 / 14
источник Habr API (хабы: Искусственный интеллект, Машинное обучение, Обработка естественного языка, топ недели)
 из статьи